Faux Googlebot dans vos logs : vérifier avant de compter
Sur sept sites, la part de faux Googlebot va de 8,8 % à 79,2 %. Voici comment séparer les vrais robots des imposteurs, pourquoi le reverse DNS seul ne suffit pas, et ce qu’un fichier de log ne peut pas prouver.
L’équipe NessFlow (Ingénierie produit, NessFlow) · · 9 min de lecture
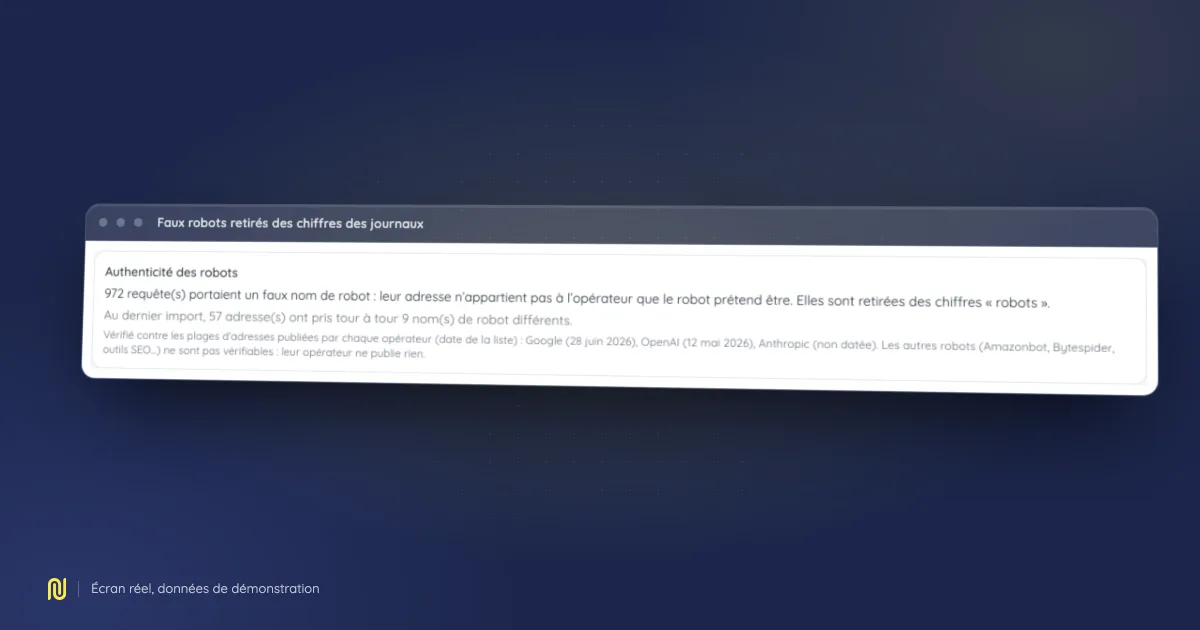
Écran réel du produit, rendu sur un jeu de démonstration fictif : les chiffres affichés ne sont ceux d’aucun client.
Sur sept sites dont nous analysons les journaux serveur, 35 714 requêtes se présentaient comme Googlebot. 20 621 venaient d’adresses qui n’appartiennent pas à Google.
Ce chiffre, à lui seul, ne veut presque rien dire. Site par site, la part de faux Googlebot va de 8,8 % à 79,2 %. Le cumul est tiré par un seul site, très visé. La médiane est de 19,8 %.
Mais même la médiane suffit à fausser tout ce qu’on lit d’habitude dans des journaux : le budget de crawl, les pages que Google visite, les erreurs qu’il rencontre, l’intérêt que lui portent les robots d’IA. Cet article explique comment séparer les vrais robots des imposteurs, ce que la vérification ne peut pas trancher, et pourquoi deux études sérieuses peuvent annoncer 5 % et 90 % de faux sans que l’une des deux se trompe.
Le relevé
Les journaux de sept sites ont été importés entre le 10 octobre et le 6 novembre 2026, puis relus le 8 novembre. Ils totalisent 550 109 requêtes de robots. Chacune a été confrontée, à l’import, aux plages d’adresses IP que publie l’opérateur dont elle porte le nom.
| Site | Requêtes « Googlebot » | Dont fausses | Part de faux |
|---|---|---|---|
| 1 | 2 065 | 181 | 8,8 % |
| 2 | 4 012 | 401 | 10,0 % |
| 3 | 2 330 | 457 | 19,6 % |
| 4 | 1 685 | 333 | 19,8 % |
| 5 | 1 652 | 428 | 25,9 % |
| 6 | 1 374 | 914 | 66,5 % |
| 7 | 22 596 | 17 907 | 79,2 % |
| Total | 35 714 | 20 621 | 57,7 % |
Les robots d’IA sont plus usurpés encore. Sur les onze robots d’IA dont l’opérateur publie ses adresses, 19 534 requêtes sur 37 532 étaient fausses, soit 52,0 %. Trois noms n’ont produit que des faux sur toute la période : Claude-SearchBot (1 551 requêtes), Perplexity-User (1 452) et MistralAI-User (1 268). Aucun vrai passage, pas un seul.
À l’inverse, certains noms ne sont presque jamais empruntés : AdsBot-Google est vérifié à 100 %, Bingbot à 96,7 %. Les imposteurs choisissent les noms qui ouvrent des portes.
Un user-agent est une déclaration
Le user-agent est un champ texte que le client remplit comme il veut. Écrire Googlebot/2.1 dans une requête prend une ligne de code, et beaucoup de sites traitent mieux ce nom-là que les autres : on ne le bloque pas, on ne lui impose pas de délai, on lui sert la page complète.
Ce que les faux robots demandent le dit assez bien. Sur les 43 771 requêtes usurpées du relevé :
- 7 321 visent un fichier de configuration
.env, sous toutes ses variantes, et d’autres demandentserver.key, des clés SSH,/proc/self/environou des identifiants de nuage. C’est du vol d’identifiants qui se fait passer pour un moteur de recherche. - 20 216 reçoivent une vraie page, avec une réponse 200. C’est de l’aspiration de contenu sous un nom qu’on n’ose pas bloquer.
- 9 230 tombent sur une 404, parce qu’elles cherchent des chemins qui n’existent pas sur le site.
Les vrais robots, eux, reçoivent une page dans 86,5 % des cas. Le profil n’a rien à voir.
Trois états, jamais deux
Une requête qui porte un nom de robot connu peut recevoir trois verdicts, et c’est le troisième qui fait toute la différence.
- Vérifiée : son adresse appartient à l’opérateur qu’elle nomme.
- Usurpée : l’opérateur publie ses adresses, et celle-ci n’en fait pas partie.
- Non vérifiable : l’opérateur ne publie rien, ou notre copie de sa liste est trop ancienne pour qu’on s’y fie.
Dans notre relevé, 72,6 % des requêtes de robots tombent dans le troisième état. Les sondes de disponibilité, les outils SEO, une bonne partie des robots qui n’annoncent qu’un nom générique, et tous les opérateurs qui ne publient pas d’adresses.
La tentation est de compter ces requêtes comme vraies, puisqu’on ne peut pas prouver qu’elles sont fausses. C’est une erreur symétrique de celle qu’on cherche à corriger. Un robot non vérifiable ajouté au total des robots d’IA gonfle une « visibilité IA » qui n’a jamais été mesurée. La seule écriture honnête garde les trois colonnes séparées, et publie le dénominateur de chacune.
La règle inverse compte autant : une requête n’est jamais déclarée usurpée parce qu’on ne sait pas la juger. Accuser à tort un vrai Googlebot, c’est risquer de le bloquer.
Vérifier à la main
Les opérateurs qui publient leurs adresses le font dans un fichier JSON, à une adresse stable. Pour Google, la liste des robots d’exploration est sur developers.google.com, et quatre autres fichiers couvrent ses robots spéciaux et ceux qui agissent à la demande d’un utilisateur. Bing, Apple, OpenAI, Perplexity, Anthropic, Mistral, DuckDuckGo et Common Crawl font de même. Meta ne publie pas de liste : la seule source est l’annonce de son réseau, l’AS 32934.
La vérification tient en quelques lignes. Ce script lit la liste de Google et juge chaque adresse qu’on lui donne :
import ipaddress, json, sys, urllib.request

LISTE = "https://developers.google.com/static/search/apis/ipranges/googlebot.json"

with urllib.request.urlopen(LISTE) as reponse:
    donnees = json.load(reponse)

plages = [
    ipaddress.ip_network(p.get("ipv4Prefix") or p.get("ipv6Prefix"))
    for p in donnees["prefixes"]
]

for ligne in sys.stdin:
    ip = ipaddress.ip_address(ligne.strip())
    verdict = "vérifiée" if any(ip in plage for plage in plages) else "usurpée"
    print(ip, verdict)
Extrayez de vos journaux les adresses des requêtes qui se disent Googlebot, passez-les au script, et comptez. Le 8 novembre 2026, il rendait ceci :
$ printf "66.249.66.1\n34.141.20.10\n" | python3 verifier.py
66.249.66.1 vérifiée
34.141.20.10 usurpée
Ce script est volontairement minimal. Il ne connaît qu’un opérateur et une liste, et il ne sait pas dire « non vérifiable ». Pour un vrai contrôle, il faut charger toutes les listes de l’opérateur et juger par opérateur, pas par robot : un vrai collecteur d’OpenAI qui porte le nom d’un de ses voisins reste un robot d’OpenAI, alors qu’une adresse de Google sous un nom d’OpenAI est une usurpation.
Le piège du reverse DNS
La méthode qu’on recopie le plus souvent est la recherche DNS inverse : on demande le nom de la machine derrière l’adresse, on vérifie qu’il finit par googlebot.com ou google.com, puis on confirme dans l’autre sens.
Elle marche, à une condition : qu’on n’accepte aucun autre suffixe. La seconde adresse du script ci-dessus a pourtant un nom tout à fait rassurant :
$ host 34.141.20.10
10.20.141.34.in-addr.arpa domain name pointer 10.20.141.34.bc.googleusercontent.com.
C’est une machine que n’importe qui peut louer sur Google Cloud. Une vérification qui accepte tout nom contenant « google », ou qui accepte googleusercontent.com sans distinguer de quel robot il s’agit, laisse passer exactement les imposteurs les mieux équipés. Les plages publiées n’ont pas ce défaut : une machine louée n’entre jamais dans la liste de Googlebot.
Le reverse DNS reste utile pour les opérateurs qui ne publient que lui, comme Amazon ou Yandex. Il se combine alors à une confirmation dans l’autre sens, jamais en lecture seule.
Pourquoi 5 % et 90 % sont vrais en même temps
Les études publiques sur les faux robots donnent des chiffres qui semblent incompatibles. Une étude menée sur le trafic agrégé de grands réseaux trouve quelques pour cent de robots d’IA usurpés. Des relevés sur un seul petit site en trouvent plus de 80 %.
Notre propre tableau donne la réponse : 57,7 % en cumul, 19,8 % en médiane. Le site 7 reçoit à lui seul 17 907 fausses requêtes, plus que les six autres réunis : il pèse presque tout dans un cumul, et compte pour une ligne sur sept dans une médiane. Le volume des imposteurs ne suit pas le trafic réel d’un site, il suit l’intérêt qu’on lui porte, et d’un site à l’autre la même grandeur change d’un facteur neuf.
Retenez deux choses. Un chiffre de faux robots ne veut rien dire sans sa méthode d’agrégation. Et un chiffre de marché ne vous dit rien de votre site : seuls vos journaux le peuvent.
Une liste périmée fabrique des coupables
Les listes d’adresses bougent. En préparant ce relevé, nous avons trouvé deux listes officielles que notre configuration ne lisait pas encore, une chez Google et une chez OpenAI, et nous les avons ajoutées. Un opérateur qui ajoute une plage et un outil qui ne relit pas sa liste produisent ensemble un faux usurpé : un vrai robot, sur une adresse neuve, déclaré imposteur.
Deux règles évitent ce défaut. Relire chaque liste tous les jours. Et quand une copie n’a pas pu être relue depuis plusieurs jours, rendre « non vérifiable » plutôt que « usurpé » pour tous les robots de cet opérateur. Une liste trop vieille de notre côté ne doit jamais faire accuser un robot.
Ce que ça coûte
Rien de tout cela n’est cher en calcul. Le coût est ailleurs.
- Tenir les listes à jour. Dix-huit listes chez dix opérateurs, à relire chaque jour, avec une garde sur la fraîcheur de chacune. Une liste qui disparaît ou change de format doit faire échouer la relève, pas vider la copie existante.
- Accepter le trou. Près des trois quarts des requêtes de robots restent non vérifiables. On peut les publier à part, on ne peut pas les déclarer vraies.
- Garder les faux en vue. Les retirer des chiffres de robots ne veut pas dire les effacer : ils restent dans le total des requêtes, et leur nombre se publie. Un site visé par 18 000 faux Googlebot a besoin de le savoir.
Ce qu’un fichier de log ne peut pas prouver
L’analyse de logs a ses limites, et il vaut mieux les connaître.
Certains opérateurs signent désormais leurs requêtes avec une signature cryptographique transmise dans les en-têtes HTTP. Un journal d’accès standard ne contient pas ces en-têtes : la preuve existe, mais pas dans le fichier.
Un agent qui se présente avec le user-agent d’un navigateur ordinaire n’est pas un robot pour le journal. Aucune vérification ne le fera réapparaître.
Enfin, derrière un CDN ou un équilibreur de charge, l’adresse écrite dans le journal peut être celle de l’intermédiaire et non celle du client. Avant de vérifier quoi que ce soit, vérifiez que vos journaux portent la vraie adresse d’origine : nos guides d’export expliquent comment.
Ensuite
Pour la méthode complète d’analyse des journaux, voyez notre guide sur l’analyse de logs serveur. Pour décider quels robots d’IA laisser entrer, voyez la configuration du robots.txt, robot par robot. Et si votre budget de crawl réel se révèle plus petit que prévu, vérifiez que vos pages importantes sont bien reliées au reste du site : une page orpheline ne se voit pas au nombre de ses liens.
Notre analyse de logs juge chaque requête de robot à l’import, contre les dix-huit listes relues chaque jour. Les faux sortent de tous les chiffres de robots, budget de crawl compris, et leur nombre est publié à part.