Analyse de logs serveur : ce que vos serveurs savent et que Search Console ignore
Les journaux serveur sont la seule source qui dise ce que les moteurs ont réellement demandé. Comment les récupérer, ce qu’on en tire, et comment le faire sans conserver une seule adresse IP.
L’équipe NessFlow (Ingénierie produit, NessFlow) · · 5 min de lecture

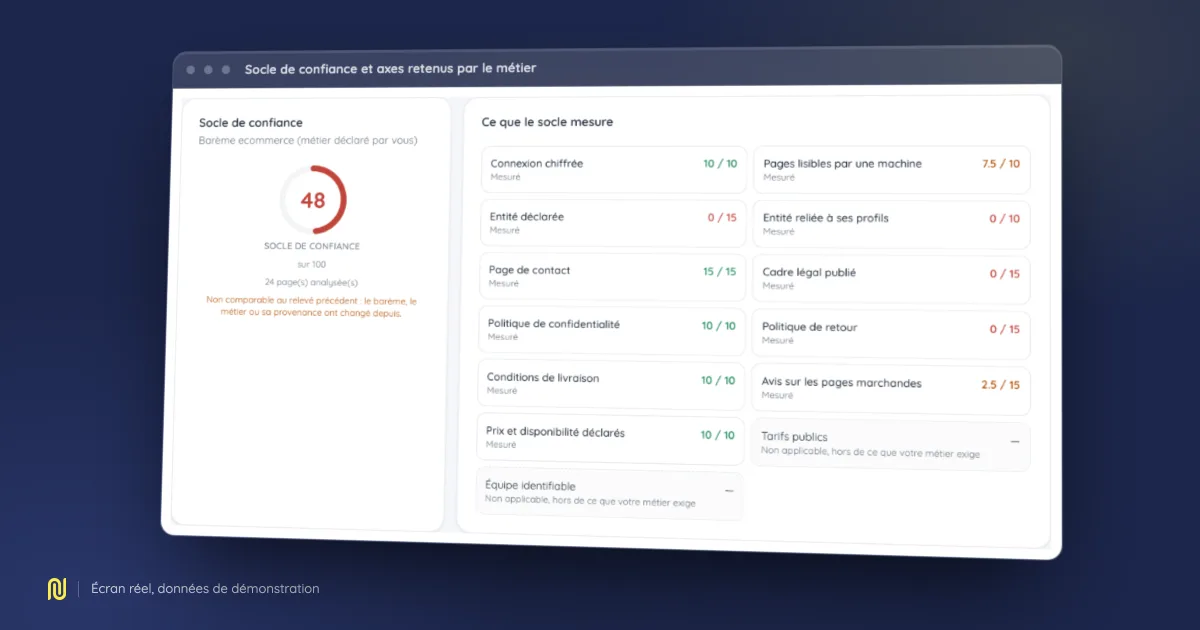
Écran réel du produit, rendu sur un jeu de démonstration fictif : les chiffres affichés ne sont ceux d’aucun client.
Search Console vous dit ce que Google a bien voulu vous dire, échantillonné et arrondi. Vos journaux serveur vous disent ce qui s’est réellement passé, requête par requête. Quand les deux se contredisent, ce sont les journaux qui ont raison, et cette contradiction est souvent le diagnostic le plus utile de tout un audit.
Ce que vous ne verrez nulle part ailleurs
Le budget de crawl réel. Personne ne le publie. Il se déduit du comportement observé : combien de pages distinctes un robot demande par jour, à quelle fréquence il revient, et où il passe son temps. Le constat le plus fréquent est déprimant et actionnable : la majorité des requêtes d’un moteur porte sur des pages sans valeur, filtres, paramètres de tri, pagination profonde.
Les pages fantômes. Des URL que les moteurs demandent régulièrement et qui n’apparaissent dans aucun crawl de votre site. Anciennes pages supprimées, paramètres oubliés, liens entrants d’un tiers. Elles consomment du budget et répondent souvent en erreur.
Les pages orphelines actives. L’inverse : des pages qui reçoivent du trafic humain alors qu’aucun lien interne n’y conduit. Elles vivent d’un lien externe ou d’un signet, et une refonte les fait disparaître sans que personne ne s’en aperçoive.
Le vrai partage humains / robots. Sur beaucoup de sites, la moitié du trafic n’est pas humaine. Dimensionner une infrastructure sans le savoir revient à payer pour des robots.
Récupérer les journaux
Selon votre hébergement :
- Serveur classique (nginx, Apache) :
/var/log/nginx/access.log*, souvent avec rotation quotidienne compressée. - CDN devant l’origine : demandez les journaux du CDN. Ceux de l’origine ne voient que ce que le cache a laissé passer, ce qui fausse tout comptage de robots.
- Hébergement mutualisé : un panneau propose généralement une archive.
Deux points à cadrer avant de demander :
- La période. Un mois est un bon départ ; une semaine ne suffit pas à voir une fréquence de retour.
- Le format. Combiné, commun, ou format personnalisé : notez-le, l’ordre des champs n’est pas devinable de façon fiable.
Le point qui bloque tout : les adresses IP
Un journal serveur contient des adresses IP. Selon le RGPD, ce sont des données à caractère personnel. C’est la raison pour laquelle beaucoup d’équipes n’analysent jamais leurs journaux : la DSI refuse de les envoyer à un tiers, et personne n’a le temps de monter une chaîne interne.
La bonne réponse n’est pas de contourner la question, c’est de ne pas conserver l’adresse. L’adresse sert à deux choses au moment du traitement : distinguer un visiteur d’un autre pour compter des sessions, et vérifier qu’un robot est bien celui qu’il prétend être. Ces deux usages se font en flux, sans écrire l’adresse nulle part.
C’est le choix que nous appliquons : le parseur lit, agrège, et n’écrit aucune adresse IP en base. Aucune n’est transmise à un modèle. Les fichiers importés sont supprimés après traitement.
Si vous montez votre propre chaîne, la règle à écrire dans votre spécification est celle-là : l’adresse peut être lue, elle ne peut pas être conservée.
Ce qu’on en tire, dans l’ordre
1. Séparer les robots des humains
Le filtrage par agent utilisateur seul ne suffit pas : la chaîne est déclarative. Pour les robots majeurs, vérifiez la revendication par résolution DNS inverse puis directe ; c’est la méthode que Google et Bing documentent. Sans cela, votre comptage de Googlebot inclut tout ce qui s’en réclame.
2. Classer les réponses par code de statut
Un pic de 404 sur des URL demandées par un robot est un budget dépensé pour rien. Un pic de 5xx pendant une fenêtre de crawl est bien pire : c’est le signal qui fait ralentir un moteur, parfois pour des semaines.
3. Croiser avec le crawl
C’est là que les journaux prennent leur valeur. Trois recoupements, sur la même URL normalisée :
- crawlée, jamais demandée par un moteur → problème de découverte, souvent de maillage interne ;
- demandée par un moteur, absente du crawl → page fantôme ;
- demandée et crawlée, mais absente de Search Console → problème d’indexation, pas d’exploration.
Le troisième cas est celui qui change le plus souvent le diagnostic d’une équipe, parce qu’il déplace le travail : cesser de chercher pourquoi le robot ne vient pas, et commencer à chercher pourquoi la page n’est pas retenue.
4. Regarder où passe le budget
Groupez les requêtes des robots par répertoire ou par motif d’URL. Si un tiers des demandes porte sur des combinaisons de filtres, vous avez votre chantier, et il est en général plus rentable que n’importe quelle optimisation de contenu.
Le piège du volume
Les journaux sont volumineux : quelques gigaoctets pour un mois sur un site actif. Deux conséquences pratiques.
Il faut lire en flux. Charger un fichier en mémoire pour le parser fonctionne jusqu’au jour où ça ne fonctionne plus, et l’échec arrive en production sur le plus gros client.
Il faut compacter les agrégats. Conserver la ligne à ligne indéfiniment ne sert à rien : au-delà de quelques semaines, ce qu’on relit est un agrégat horaire, puis quotidien. Décidez de la rétention avant d’importer, pas après.
Ce que ça ne dit pas
Les journaux disent ce qui a été demandé, pas ce qui en a été fait. Une page explorée n’est pas une page indexée ; une page indexée n’est pas une page affichée. Le croisement avec Search Console reste nécessaire pour la deuxième étape, et rien ne renseigne complètement la troisième.
C’est la limite honnête de l’exercice, et elle vaut mieux qu’un tableau de bord qui prétend le contraire.