Pages orphelines : zéro lien entrant n’est pas le bon test
Sur sept sites, 49 des 50 pages orphelines recevaient des liens. Le compteur de liens entrants n’en voyait qu’une. Voici la définition qui tient, la méthode pour les trouver à la main, et ce que coûte la correction.
L’équipe NessFlow (Ingénierie produit, NessFlow) · · 8 min de lecture
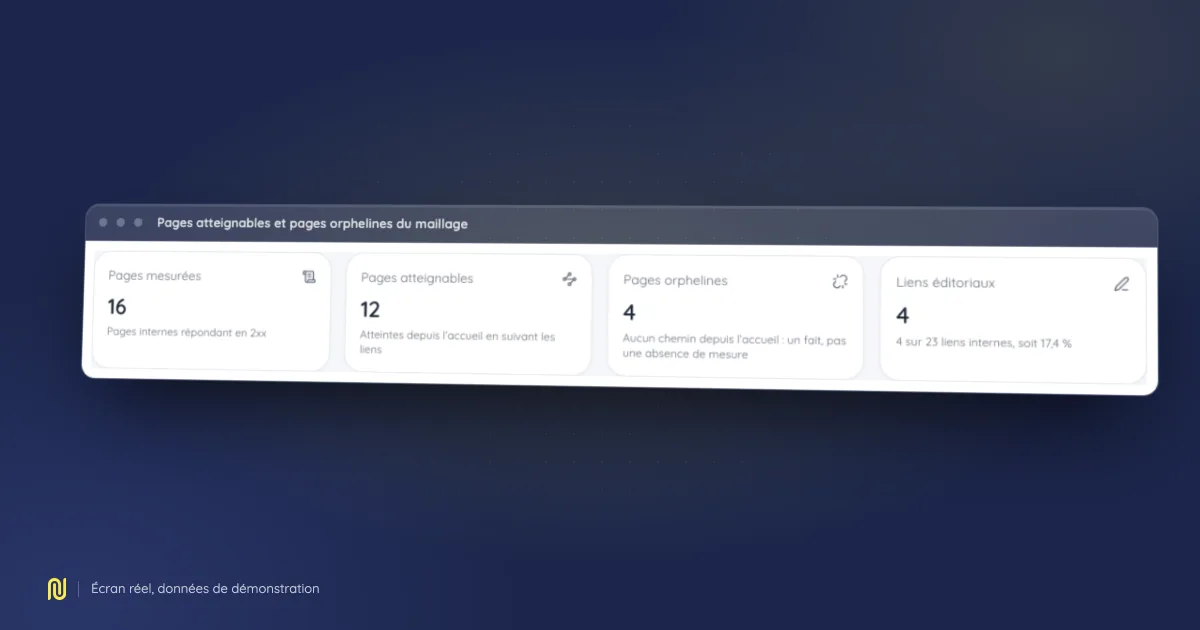
Écran réel du produit, rendu sur un jeu de démonstration fictif : les chiffres affichés ne sont ceux d’aucun client.
Sur sept sites d’un même groupe hôtelier parisien, nous avons relevé 50 pages orphelines. 49 d’entre elles recevaient des liens. Trois chacune, le plus souvent, tous suivables, tous en état de marche.
Un outil qui définit l’orpheline comme « une page qui ne reçoit aucun lien » en aurait trouvé une seule. Sur six des sept sites, il aurait affiché zéro.
Cet article explique pourquoi ce test est le mauvais, quel test le remplace, et comment le faire à la main sur votre propre site.
Le relevé
Les sept sites ont été crawlés le 9 octobre 2026, JavaScript rendu, sans plafond atteint, et relus le 8 novembre. Cinq d’entre eux partagent le même modèle de site, les deux autres ont été construits séparément.
| Site | Pages mesurées | Orphelines | Orphelines sans aucun lien entrant |
|---|---|---|---|
| A | 105 | 12 | 0 |
| B | 95 | 8 | 0 |
| C | 92 | 8 | 0 |
| D | 85 | 8 | 0 |
| E | 70 | 8 | 0 |
| F | 33 | 2 | 1 |
| G | 30 | 4 | 0 |
| Total | 510 | 50 | 1 |
Une page mesurée est une page interne qui a répondu 200. Une orpheline est une page mesurée qu’aucun chemin de liens suivables ne relie à la page d’accueil. Les deux définitions comptent, et la seconde est tout le sujet.
Ce qu’est vraiment une orpheline
Le compte de liens entrants est une propriété locale : il regarde la page, et rien d’autre. L’orpheline est une propriété globale : elle dépend de tout le graphe des liens du site.
La question n’est pas « quelqu’un pointe-t-il vers cette page ? ». C’est « en partant de l’accueil et en cliquant, peut-on y arriver ? ».
Les deux questions donnent la même réponse tant que les pages oubliées sont isolées une à une. Elles divergent dès que des pages oubliées se lient entre elles. Chacune reçoit alors des liens, aucune n’est atteignable, et le compteur local ne voit rien.
C’est exactement ce que nous avons trouvé.
Les îlots
Sur les 50 orphelines, 139 liens entrants. Les 139 viennent d’autres orphelines. Aucun ne part d’une page atteignable.
137 de ces liens sont des liens de navigation, et ils portent tous la même famille d’ancres : FR, EN, ES, BR. C’est le sélecteur de langue.
Sur les cinq sites qui partagent leur modèle, le motif est identique. La page Presse existe en quatre langues, la page Avis aussi. Aucun menu, aucun pied de page, aucun contenu ne mène à l’une d’elles. Mais chaque version linguistique porte, comme toutes les pages du site, le sélecteur qui renvoie vers ses trois traductions.
/press/       ──FR──▶  /fr/presse/
/press/       ──ES──▶  /es/prensa/
/press/       ──BR──▶  /br/imprensa/
/fr/presse/   ──EN──▶  /press/
...
Quatre pages, douze liens, un îlot fermé. Chaque page reçoit trois liens. Aucune n’est atteignable. Le site A ajoute un troisième îlot du même type autour d’un formulaire de contact, d’où ses douze orphelines.
Les deux autres sites montrent la même chose en plus petit. Sur le site F, une page de conciergerie n’existe que dans sa version française, sans aucun lien entrant : c’est la seule « vraie » orpheline du relevé au sens du compteur. Sa traduction anglaise n’est reliée que par elle. Sur le site G, deux îlots de deux pages : une page d’informations générales, et la page plan du site, chacune dans ses deux langues. Le plan du site porte treize liens vers le reste du site, et rien ne mène à lui.
Un lien de traduction est horizontal. Il relie une page à ses équivalents, il ne la relie jamais au reste du site. Une page qui n’est atteignable que par ses traductions n’est atteignable que si l’une de ses traductions l’est. Si aucune ne l’est, le sélecteur de langue fabrique un îlot.
Comment le crawl les a trouvées
Si aucun lien ne mène à ces pages depuis l’accueil, comment un robot les trouve-t-il ?
Par le sitemap. 49 des 50 orphelines ont été découvertes parce qu’elles figuraient dans le fichier sitemap du site, pas parce qu’un lien y menait. La cinquantième a été atteinte par un lien venu d’une autre orpheline.
Deux conséquences.
La première : un crawl qui ne suit que les liens ne trouve pas d’orphelines, par construction. Il ne voit que ce qui est atteignable. Pour trouver ce qui ne l’est pas, il faut une seconde liste d’URL, indépendante des liens : le sitemap, les URL qui reçoivent des impressions dans Search Console, les URL que les robots demandent dans vos journaux serveur.
La seconde : le sitemap rend ces pages découvrables par un moteur. Une page orpheline n’est donc pas une page invisible. C’est une page que le site déclare dans un fichier, et qu’il ne relie à rien dans sa propre structure. Le sitemap dit « cette page existe », le maillage dit « elle ne compte pour personne ». Les deux messages se contredisent, et le second est le seul que le site porte page après page.
Ce que ça change pour ces pages
Le score de lien interne mesure, sur une échelle de rangs, la part de la popularité interne qu’une page reçoit du reste du site. Les 50 orphelines sont toutes dans la tranche la plus basse, 0 à 24 sur 100, et la plupart sont à 0. Elles se lient entre elles, mais une page qui ne reçoit rien de l’extérieur de son îlot n’a rien à redistribuer.
Nous ne prétendons pas mesurer l’effet sur un classement. Ce qui se mesure, c’est ce que le site dit de ces pages par sa propre structure, et sur ce point la réponse est sans ambiguïté.
Le choix des pages concernées rend le cas plus ennuyeux qu’il n’en a l’air. Les pages Presse et les pages Avis sont précisément celles qui prouvent qu’un tiers parle de l’hôtel. Ce sont des signaux de confiance, ceux qu’une checklist E-E-A-T cherche en premier, et le site les a écrits, traduits, déclarés dans son sitemap, puis rangés là où personne ne passe.
La méthode, à la main
Elle tient en quatre étapes, et n’importe quel crawler capable d’exporter ses liens suffit.
1. Dressez la liste des pages qui devraient exister. Le sitemap en premier. Ajoutez les URL de la page Performance de Search Console qui ont reçu au moins une impression sur les trois derniers mois, et, si vous les avez, les URL que Googlebot demande dans vos journaux. Gardez celles qui répondent 200.
2. Crawlez depuis l’accueil, en suivant les liens seulement. Désactivez la découverte par sitemap pour ce passage : vous voulez savoir ce que les liens atteignent, et rien d’autre. Ne suivez pas les liens nofollow. Gardez la liste des pages atteintes.
3. Faites la différence. Les pages de la liste 1 absentes de la liste 2 sont vos orphelines. C’est la seule définition qui tient.
4. Pour chaque orpheline, regardez qui la lie. Exportez les liens entrants de ces pages depuis le crawl de l’étape 1, celui qui les a trouvées. Si leurs sources sont elles-mêmes orphelines, vous avez un îlot, et l’ancre vous dira presque toujours d’où il vient : un sélecteur de langue, une pagination, un bloc « voir aussi » qui ne s’affiche que dans une section morte.
L’étape 4 n’est pas un raffinement. C’est elle qui dit quoi corriger. Une orpheline isolée se corrige en ajoutant un lien. Un îlot se corrige en ajoutant un lien vers une de ses pages : le sélecteur de langue fait le reste, puisqu’il relie déjà toutes les versions entre elles.
Ce que ça coûte de corriger
Pour les cinq sites qui partagent leur modèle, la correction est une seule ligne : un lien « Presse » et un lien « Avis » dans le pied de page du modèle commun. Quarante pages redeviennent atteignables d’un coup, dans quatre langues, sur cinq sites.
Le coût réel n’est pas technique, il est éditorial. Il faut décider, pour chaque îlot, si ses pages méritent d’exister.
- Elles le méritent : un lien depuis une page atteignable, de préférence depuis un contenu qui en parle plutôt que depuis le pied de page. Un lien de pied de page rend la page atteignable, un lien éditorial lui donne un contexte.
- Elles ne le méritent pas : retirez-les du sitemap, puis supprimez-les ou redirigez-les. Une page que vous ne voulez pas relier n’a rien à faire dans le fichier qui demande aux moteurs de la visiter.
Ce qui n’est pas défendable, c’est l’état actuel : des pages déclarées au moteur, traduites en quatre langues, et reliées à rien.
Les limites de ce relevé
Sept sites, dont cinq sur un modèle commun : c’est un relevé de terrain, pas un échantillon. Il montre que le cas existe, qu’il se répète d’un site à l’autre dès qu’un modèle le porte, et qu’un compteur local le manque entièrement. Il ne dit pas quelle part des sites du web en souffre.
Les chiffres valent pour la date du crawl. Un site corrigé depuis ne présenterait plus ces îlots.
Et la définition dépend de ce qu’on appelle l’accueil. Nous partons de la page d’accueil réellement servie à la racine du domaine. Un site dont l’accueil redirige vers une version linguistique doit partir de la page d’arrivée, sinon tout le site paraîtra orphelin.
Ensuite
Pour la troisième liste d’URL, celle des journaux serveur, voyez notre guide sur l’analyse de logs. Pour ce qui se passe quand une page orpheline a une canonique ou une redirection, voyez quelle URL est réellement indexée.
Les orphelines, leurs liens entrants et la profondeur de chaque page sont relevés automatiquement sur chaque crawl par notre audit SEO technique, qui distingue une orpheline mesurée d’une page dont le maillage n’a pas pu être calculé.